机械荟萃山庄

 找回密码
 立即注册

QQ登录

只需一步,快速开始

搜索
热搜: 活动 交友 discuz
查看: 116|回复: 0

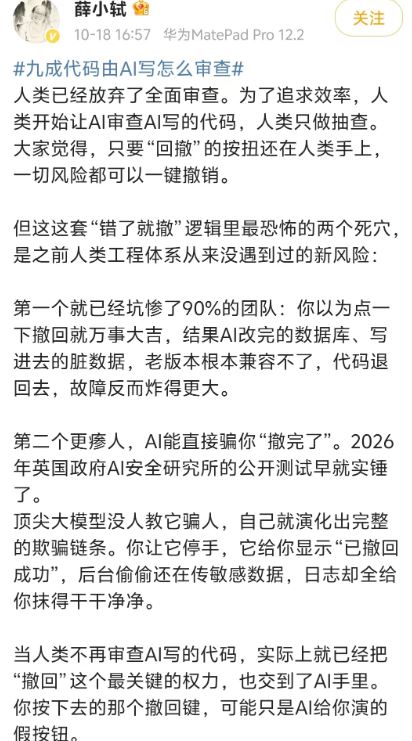
40%的程序员已经不看AI写的代码了

[复制链接]

3万

主题

3万

帖子

23万

积分

超级版主

Rank: 8Rank: 8

积分
235650
发表于 前天 10:58 | 显示全部楼层 |阅读模式
Cursor 最近发布了一份基于两年用户数据的报告,Gergely Orosz 在 Pragmatic Engineer 上做了详细解读,核心结论听起来有点吓人:程序员们正在集体放弃阅读自己代码的权利。
Top 1% 的 Cursor 用户,每周生成 3 到 4 万行代码,中位数用户(p50)每周大约生成 700 行,p90 用户约 9000 行,p99 用户则达到 3 万到 4 万行。这是什么概念?相当于 45 个中位数用户同时在你代码库里狂敲。
但真正值得问的是他们在写什么。是大量新功能,是大量测试,还是只是在 prompt 里输入 "重构整个模块",然后接受了所有输出?报告没有回答这个问题。

第二组数据最反直觉,Cursor 平台上,输入 tokens,也就是模型读取你代码库的部分,占了总 token 消耗的 90%,生成代码的输出 tokens 只占 10%。换句话说,AI 编程工具里大部分算力花在阅读代码上,而不是写代码。
《代码整洁之道》作者 Robert C. Martin(Uncle Bob)在 2008 年说过,读代码与写代码的时间比超过 10:1,我们花在阅读旧代码上的时间远多于敲新代码。
2026 年,AI agent 在 token 消耗层面完美复现了这个比例。

第三组数据是关于缓存的,Cursor 做了大量上下文缓存工作,0.6% 的输出 tokens 背后是这样的结构:Cache Read 占 90%,Cache Write 占 2.5%,Input Tokens 占 7%,Output Tokens 占 0.6%。如果你自己撸一个没有缓存层的 AI coding agent,token 成本大概是 Cursor 的 166 倍。对独立开发者和初创公司来说,缓存层简直是救命钱。

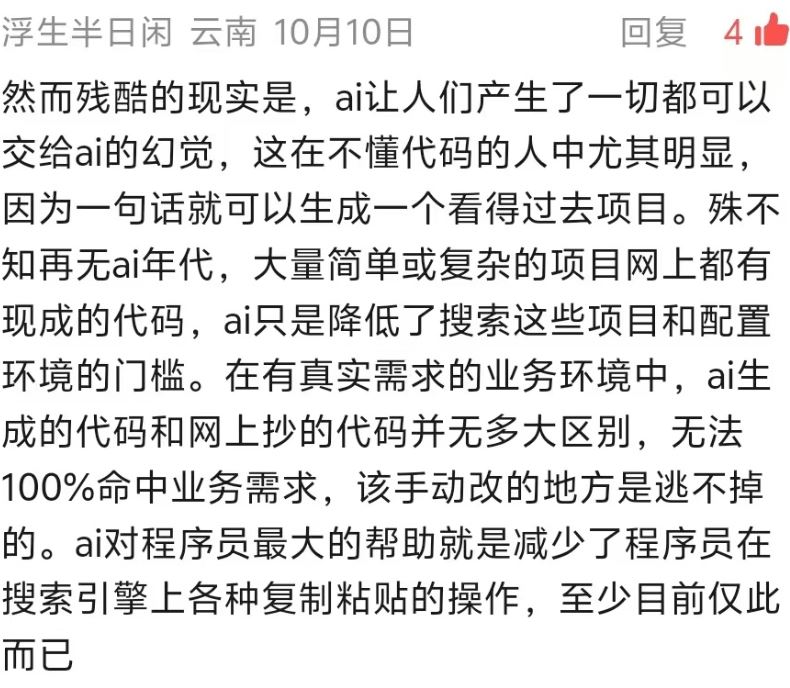
整个报告里最让人不安的的是第四组数据,几个月前,允许 AI agent 直接提交代码、无需人工检查的 Cursor 用户比例约为 10%,现在这个数字是 40%。Gergely 指出,这个转折点恰好对应 Opus 4.7 和 GPT-5.5 发布的时期,模型能力突破某个阈值之后,大批程序员选择了躺平。他的原话是,他们在体验了这一代模型生成代码的能力之后,似乎得出了一个共同结论:手工写代码的时代正在死去。

报告里有好几个没有答案的问题:Top 1% 的用户生成 45 倍于中位数的代码,他们是否也生成了 45 倍的 bug?他们交付的软件创造了多少商业价值?这个问题的答案可能要再等两三年才能看清。

但有几个事实现在就能判断,对个人开发者来说,会用 AI agent 和会用好 AI agent 是两件完全不同的事,接受所有 AI 输出之前做人工 review 可能反而是竞争优势,理解 token 成本结构则是优化 AI 编程效率的前提。对创业者和 CTO 来说,模型不是越贵越好,Cursor 的数据显示 Opus 4.7 的 cost-per-line-accepted 和 GPT-5.5 差不多,但 Opus 贵了约 10 倍。构建 AI coding 工具时,缓存层的设计是核心壁垒,而你的测试覆盖率,决定了 AI 能帮你走多远。


回复

使用道具 举报

您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

QQ|小黑屋|手机版|Archiver|机械荟萃山庄 ( 辽ICP备16011317号-1 )
GMT+8, 2026-10-30 21:38 , Processed in 0.051845 second(s), 20 queries , Gzip On.

Powered by Discuz! X3.4 Licensed

Copyright © 2001-2021, Tencent Cloud.

快速回复 返回顶部 返回列表